
Как проверить JavaScript-сайт на SEO-ошибки в Labrika
После переноса каталога на React или Vue товары могут выглядеть правильно в браузере, но получать одинаковые заголовки, неверные canonical или ссылки без адресов. Режим обработки JavaScript в Labrika позволяет проверить содержимое после выполнения скриптов и собрать конкретные URL для разработчика. Он полезен при приёмке нового шаблона и перед запуском продвижения динамического сайта.
Включите обработку JavaScript
Откройте настройки сайта → «Дополнительные настройки» → «Настройки сканирования сайта». Включите «Парсить JavaScript (за каждую страницу будет списано 2 лимита парсинга страниц вместо 1)» и сохраните настройки.
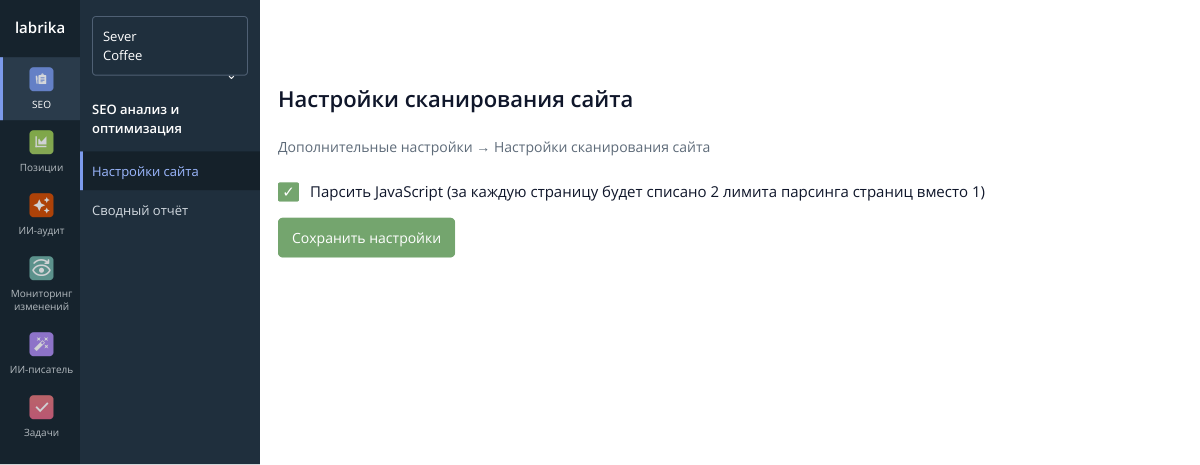
1. Путь начинается в «SEO» → «Настройки сайта». В «Дополнительные настройки» откройте параметры сканирования, включите JS и сохраните. Показан фрагмент интерфейса; данные примера условные.
Режим нужен, когда важное содержимое действительно создаётся скриптами. Если сервер уже отдаёт готовые заголовки, ссылки и текст, сам по себе React или Vue не требует включать JS для каждого аудита.
Настройте папки для анализа и исключения
В тех же «Настройках сканирования сайта» есть два списка: «Папки для сканирования» и «Исключить файлы и папки». С их помощью можно проверять нужные разделы и пропускать служебные страницы. Например, после обновления каталога на React — проверить товары и аксессуары, исключив страницы сравнения и варианты сортировки. Это помогает направить лимиты JS-проверки на страницы, которые вы продвигаете.
Добавьте нужные папки в анализ
В список «Папки для сканирования» внесите каждый путь с новой строки: например, /coffee/ и /accessories/. Можно указывать и полные адреса, например https://shop.example/coffee/. Labrika начнёт обход с указанных адресов и будет проверять найденные страницы внутри этих папок: правило /coffee/ подходит и для /coffee/model-a.
Для анализа папок вместе с вложенными страницами оставьте флажок «Исключить все остальные страницы» выключенным. Включайте его, если нужны только конкретные URL из списка — например, несколько карточек после исправления шаблона. В этом случае перечислите адреса самих карточек.
Исключите ненужные страницы
В список «Исключить файлы и папки» также добавляйте по одному правилу на строку. Например, /coffee/compare/ исключит страницы сравнения в этой папке, а *sort=* — адреса с параметром сортировки sort=. Здесь используются правила по аналогии с robots.txt; исключения действуют и внутри выбранных для анализа папок.
Если нужно проверять весь сайт, пропуская только ненужные разделы, оставьте «Папки для сканирования» пустым и заполните только список исключений. Если нужны определённые разделы с исключениями внутри них, заполните оба списка, как в примере ниже.
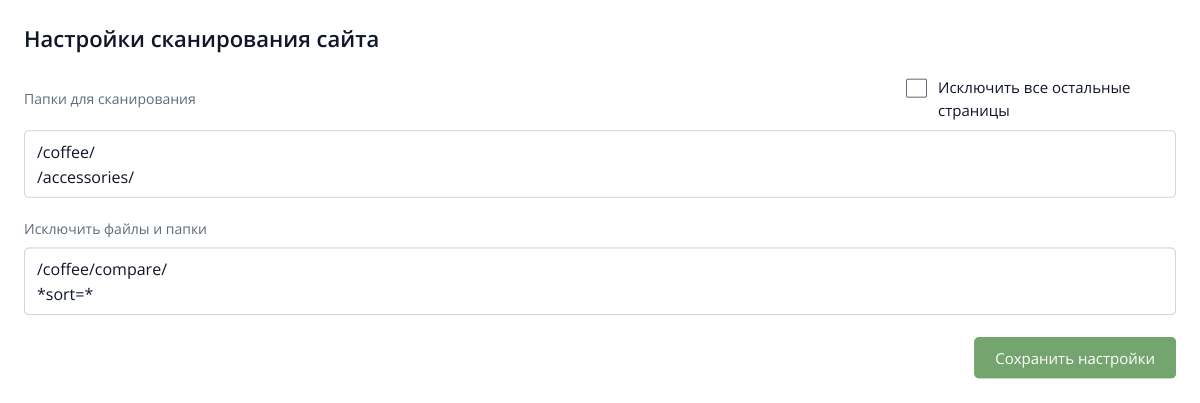
2. Пример: анализируем две папки с вложенными страницами, пропуская сравнение товаров и URL с параметром sort=. Флажок выключен, чтобы обход не ограничивался двумя адресами из верхнего списка.
Нажмите «Сохранить настройки», затем «Запустить проверку сайта» и выполните полный аудит. В нашем примере в результатах нужны страницы из /coffee/ и /accessories/, включая найденные карточки товаров; страницы сравнения и сортировки исключены. Если нужная карточка находится в другой папке — например, /products/, — добавьте и этот путь в список для сканирования.
Проверьте элементы, которые создаёт приложение
Начните с «SEO-аудит» → «Дубли TITLE» и «SEO-ошибки META тегов». Например, у двадцати карточек остался Title «Каталог», хотя на экране показаны разные названия товаров. Передайте разработчику выборку URL: в шаблоне нужно формировать Title из данных соответствующего товара. Затем в «Технический аудит» → «Страницы с rel=canonical» проверьте, что карточки указывают на выбранные основные адреса, а не все на категорию.
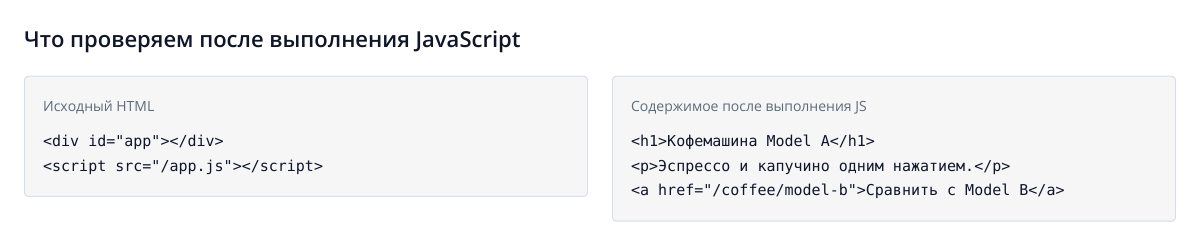
3. Авторский пример: после выполнения скрипта появляются заголовок, описание и ссылка на другой товар.
В разделе «Ссылочные» откройте «Внутренние ссылки» и проверьте переходы из категории к карточкам. Если товар открывается только обработчиком JavaScript, попросите разработчика добавить обычную ссылку с адресом: <a href="/coffee/model-a">Model A</a>. Google рекомендует именно ссылки с href для обнаружения страниц — см. документацию по JavaScript SEO.
После исправления повторите проверку с теми же настройками JS и той же областью сканирования. Когда шаблон работает правильно, расширьте аудит на весь нужный каталог.
При повторной проверке откройте те же отчёты: общий Title должен исчезнуть из дублей, canonical — вести на нужные страницы, а ссылки — находиться в навигации. Сохраните результаты для приёмки релиза и расширьте область аудита на остальные категории, использующие этот шаблон.