
Анализ llms.txt
Файл llms.txt — это карта сайта для языковых моделей. Он лежит в корне сайта, написан в Markdown и предлагает ИИ то же, что robots.txt предлагает поисковым роботам, только наоборот: не запреты, а навигацию. «Вот как называется наш проект, вот о чем он, вот ссылки на самые важные страницы — начинайте отсюда». Нейросети, которые собирают ответы о вашей компании, охотно пользуются такими картами — при условии, что файл составлен аккуратно и действительно существует по адресу /llms.txt.
Отчет Анализ llms.txt загружает ваш файл и сверяет его со спецификацией. Ниже — пример результата для сайта, у которого файла пока нет: сервер на запрос ответил кодом 404 (тип ответа — text/html, то есть обычная страница ошибки), оценка не выставлена (—). Разберем, что означает каждый пункт проверки.
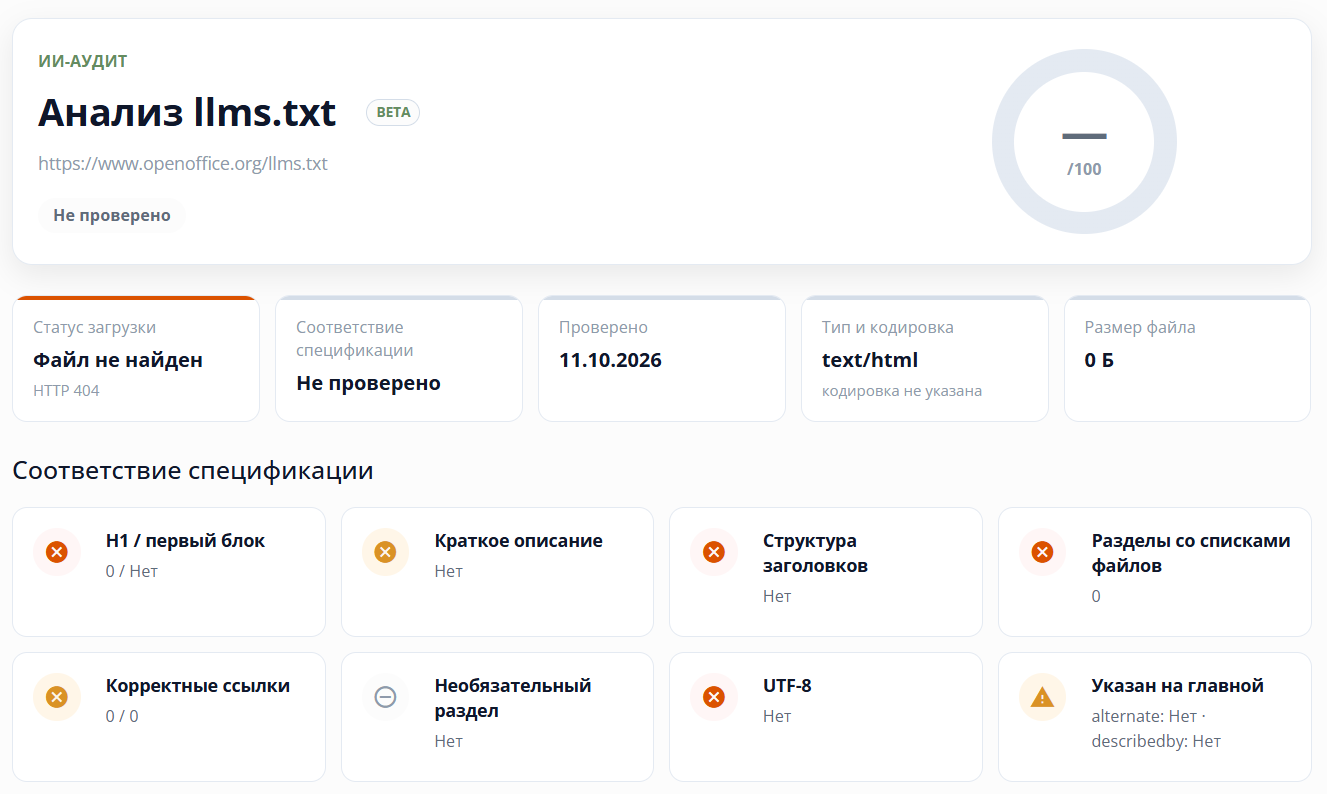
Что проверяется
Статус загрузки
Первый вопрос — на месте ли файл вообще. Отчет запрашивает https://ваш-сайт/llms.txt и смотрит ответ сервера. Возможные исходы:
- Файл получен — переходим к проверкам содержимого;
- Файл не найден, HTTP 404 — файла нет по стандартному пути. Обратите внимание на деталь из примера: сервер отдал код
404с типомtext/html— это страница ошибки, а не текстовый файл. Тип и размер (0 Б) в отчете показываются именно для того, чтобы отличить «файл есть, но битый» от «файла нет»; - Сервер не отвечает или файл слишком большой — проверка не выполнена. В обоих случаях содержимое на момент проверки не сохраняется, о чем отчет сообщает отдельной пометкой.
Проверки соответствия спецификации
Если файл получен, отчет сверяет его со спецификацией llms.txt. Вот полный список пунктов и их смысл:
| Проверка | Что ожидает спецификация |
|---|---|
H1 / первый блок |
Файл начинается с заголовка первого уровня — названия проекта. Это единственный обязательный элемент спецификации; в отчете отображается, сколько заголовков H1 найдено и есть ли они в первом блоке. |
Краткое описание |
Сразу после H1 — цитата (строка в Markdown, начинающаяся с символа >) с кратким резюме проекта в одну строку. |
Структура заголовков |
После описания идут разделы второго уровня H2. Заголовки H3 и глубже, как и второй H1, спецификацией не предусмотрены. |
Разделы со списками файлов |
Каждая секция H2 — это Markdown-список ссылок вида [Название](URL): примечание, а не абзацы текста. |
Корректные ссылки |
Ссылки в списках оформлены по схеме [имя](адрес). В отчете показывается соотношение: сколько корректных из найденных. |
Необязательный раздел |
Секция с названием Optional для второстепенных материалов: агенты с ограниченным контекстом могут её пропустить. |
UTF-8 |
Файл отдается в кодировке UTF-8. Отдельно отмечается, если кодировка не указана вовсе — как в примере выше. |
Указан на главной
Хороший llms.txt не должен быть тайником. Спецификация предлагает анонсировать его с главной страницы двумя связями: rel="describedby" указывает на llms.txt, который описывает страницу, а rel="alternate" с типом text/markdown — на Markdown-версию самой страницы. Обе можно задать тегом <link> в шапке или HTTP-заголовком ответа. В отчете видны оба признака: в примере их нет (alternate: Нет · describedby: Нет), то есть ИИ-агент сможет найти файл только прямым перебором стандартного адреса — работает, но менее надежно.
Как выглядит правильный файл
Минимальный корректный llms.txt укладывается в несколько строк:
# Название проекта

> Одно предложение о том, что это за проект и кому он полезен.

Дополнительный контекст в свободной форме, если он нужен.

## Разделы

- [Главная](https://site.ru/): описание компании и услуг
- [Цены](https://site.ru/prices/): тарифы и условия работы
- [FAQ](https://site.ru/faq/): ответы на частые вопросы

## Optional

- [Блог](https://site.ru/blog/): статьи и кейсы
Обязателен только H1 — всё остальное спецификация оставляет на ваше усмотрение, но порядок частей фиксированный: заголовок, цитата, свободный текст, секции ссылок.
Как исправить типичные проблемы
- HTTP 404. Файла нет — создайте его в корне сайта и убедитесь, что сервер отдает его напрямую, а не через редирект. Тип ответа должен быть текстовым, а не
text/html. - Кодировка не указана или не UTF-8. Добавьте в ответ сервера заголовок
Content-Type: text/markdown; charset=utf-8и пересохраните файл в UTF-8 без BOM. - Нет H1 или краткого описания. Начните файл с
# Название, сразу за ним — строка цитаты с>. Это первые две вещи, которые «считывает» и парсер, и модель. - Разделы с прозой вместо списков. По статистике это самая частая ошибка: больше половины опубликованных llms.txt содержат в секциях H2 обычные абзацы вместо списков ссылок. Перенесите пояснения после ссылок — через двоеточие внутри пункта списка.
- Битые ссылки. Проверьте каждый адрес из файла: ссылка на несуществующую страницу — это не только ошибка в отчете, но и потерянный шанс попасть в ответ ИИ.
- Не указан на главной. Добавьте в
<head>строку<link rel="describedby" href="/llms.txt">— или задайте её HTTP-заголовком на уровне сервера или CDN.
Коротко
llms.txt — недорогая инвестиция в видимость в эпоху ответов нейросетей: один файл, который помогает ИИ понять структуру сайта и находить нужные страницы. Отчет «Анализ llms.txt» показывает, где ваш файл соответствует спецификации, а где спотыкается, — осталось внести правки и перезапустить проверку.