
Доступ ИИ-роботов
Если сайт не видят поисковые роботы — его нет в поиске. С ИИ-сервисами логика та же: ChatGPT, Claude, Perplexity и Gemini собирают ответы, опираясь на контент, который их краулеры смогли прочитать. Верно и обратное: пока в robots.txt стоит запрет для GPTBot, тексты вашего сайта не должны попадать в обучение моделей OpenAI. Отчет Доступ ИИ-роботов показывает, как правила вашего robots.txt воспринимают все основные ИИ-краулеры — чтобы вы управляли доступом осознанно, а не вслепую.
Что показывает отчет
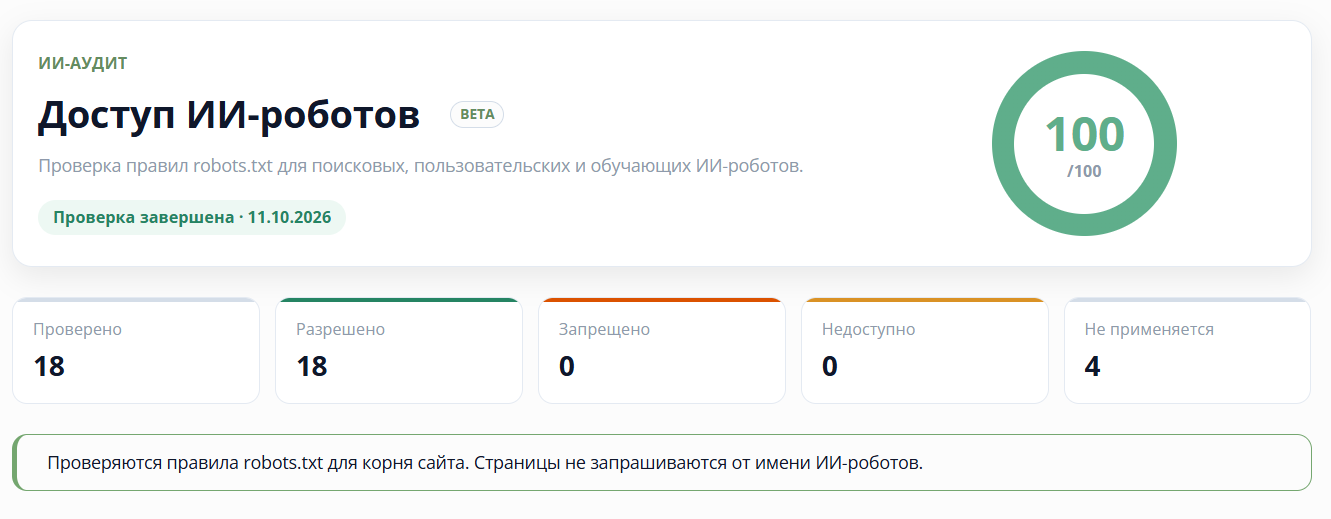
Проверка анализирует правила robots.txt в корне сайта для каждого известного ИИ-робота. Сами страницы при этом не запрашиваются от имени ИИ-роботов — проверяются только правила файла. Результат сводится в оценку и счетчики:
- Оценка — сводный балл готовности настроек доступа, от 0 до 100;
- Проверено — сколько роботов участвовало в проверке;
- Разрешено — сколько роботов могут обходить сайт по текущим правилам;
- Запрещено — сколько роботов закрыто директивами
Disallow; - Недоступно — сколько роботов проверка не смогла оценить (например, файл
robots.txtне отвечает или недоступен); - Не применяется — сколько роботов не подпадают под действие
robots.txtпо своей природе.
В примере ниже ситуация идеальная: оценка 100/100, все 18 проверенных роботов разрешены, запрещенных и недоступных нет, еще 4 робота отмечены как «не применяется».
Три класса ИИ-роботов
Ключ к пониманию отчета — колонка «Назначение». ИИ-краулеры делятся на три группы, и запрет для каждой дает разный эффект:
- Поиск и ответы. Боты, которые индексируют сайт для поисковой выдачи ИИ-сервисов:
OAI-SearchBotу ChatGPT Search,PerplexityBotу Perplexity,Claude-SearchBotу Anthropic,DuckAssistBotу DuckDuckGo. Если закрыть такого бота, сайт перестает попадать в ответы и поисковую выдачу соответствующего сервиса — вместе с возможным трафиком. - Обучение моделей. Краулеры, которые собирают контент для обучения будущих версий моделей:
GPTBotу OpenAI,ClaudeBotу Anthropic,CCBotу Common Crawl,Grokbotу xAI. Запрет здесь не влияет на показ сайта в поиске и в ответах со ссылками — но тексты перестают использоваться для тренировки моделей. - Запрос пользователя. Агенты, которые заходят на страницу, когда человек сам просит об этом:
ChatGPT-Userу OpenAI,Claude-Userу Anthropic,Perplexity-Userу Perplexity. Это не автоматический обход — робот приходит по конкретной просьбе пользователя проверить ссылку или процитировать страницу.
Колонка «Учитывает robots.txt»
Не менее важна колонка «Учитывает robots.txt» — она подсказывает, услышат ли роботы ваши директивы вообще:
- Учитывает. Робот соблюдает правила
robots.txtпо документации разработчика. Запрет для него сработает. - Не учитывает. По документации разработчика правила
robots.txtк такому роботу могут не применяться — это характерно для агентов по запросу пользователя вродеChatGPT-User. Если страницу действительно нужно скрыть от таких агентов, одногоrobots.txtнедостаточно: понадобится ограничение на уровне сервера, авторизация или правила CDN и WAF. - Не применяется. Особая категория. Например,
Google-ExtendedиApplebot-Extended— это не самостоятельные краулеры, а «токены»: страницы забирает обычныйGooglebotилиApplebot, а эти токены определяют, можно ли использовать полученный контент для обучения моделей. Отдельный обход под собственным именем они не ведут, поэтому вердикт «разрешён или запрещён» к ним не применим.
Таблица роботов
Основная часть отчета — таблица с проверенными роботами. Вот как она выглядит для сайта со полностью открытым доступом:
| Робот | Провайдер | Назначение | Учитывает robots.txt | Результат |
|---|---|---|---|---|
Amazonbot |
Amazon | Поиск и ответы | Учитывает | Разрешён |
Applebot |
Apple | Поиск и ответы | Учитывает | Разрешён |
Applebot-Extended |
Apple | Обучение моделей | Не применяется | Не применяется |
bingbot |
Microsoft | Поиск и ответы | Учитывает | Разрешён |
CCBot |
Common Crawl | Обучение моделей | Учитывает | Разрешён |
ChatGPT-User |
OpenAI | Запрос пользователя | Не учитывает | Не применяется |
ClaudeBot |
Anthropic | Обучение моделей | Учитывает | Разрешён |
Claude-SearchBot |
Anthropic | Поиск и ответы | Учитывает | Разрешён |
Claude-User |
Anthropic | Запрос пользователя | Учитывает | Разрешён |
DuckAssistBot |
DuckDuckGo | Поиск и ответы | Учитывает | Разрешён |
Google-Extended |
Обучение моделей | Не применяется | Не применяется | |
Googlebot |
Поиск и ответы | Учитывает | Разрешён | |
GPTBot |
OpenAI | Обучение моделей | Учитывает | Разрешён |
Grokbot |
xAI | Обучение моделей | Учитывает | Разрешён |
meta-externalagent |
Meta | Обучение моделей | Учитывает | Разрешён |
meta-externalfetcher |
Meta | Обучение моделей | Учитывает | Разрешён |
MistralAI-Index |
Mistral AI | Поиск и ответы | Учитывает | Разрешён |
MistralAI-Training |
Mistral AI | Обучение моделей | Учитывает | Разрешён |
MistralAI-User |
Mistral AI | Запрос пользователя | Учитывает | Разрешён |
OAI-SearchBot |
OpenAI | Поиск и ответы | Учитывает | Разрешён |
PerplexityBot |
Perplexity | Поиск и ответы | Учитывает | Разрешён |
Perplexity-User |
Perplexity | Запрос пользователя | Не учитывает | Не применяется |
Как управлять доступом
Файл robots.txt лежит в корне сайта и позволяет задать правила для каждого робота по имени. Самые ходовые сценарии:
Полный допуск. Специальные правила не нужны: если робот не упомянут, он может обходить сайт. Это вариант по умолчанию — именно так выглядит пример из таблицы выше.
Запретить обучение, сохранить видимость. Стратегия для тех, кто хочет попадать в ответы ИИ, но не отдавать контент на тренировку моделей:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Такой запрет не влияет на классический поиск: Googlebot и bingbot продолжат работать как раньше.
Полный запрет для конкретного робота. Каждый агент требует отдельного блока — перечислять имена через запятую в одной директиве нельзя:
User-agent: PerplexityBot
Disallow: /
После правок robots.txt перезапустите проверку в отчете — статусы в таблице должны обновиться.
Чего robots.txt не делает
Важно держать в голове границы инструмента. robots.txt — это просьба, а не замок: добросовестные роботы крупных компаний соблюдают его по своей документации, но никто не гарантирует, что сканер со смененным User-Agent последует тем же правилам. Файл не защищает контент от копирования, не запрещает индексацию (для этого есть noindex и заголовок X-Robots-Tag) и не заменяет авторизацию для закрытых разделов. Если какие-то страницы нельзя показывать никому — закрывайте их техническими средствами, а не строчкой в robots.txt.
Коротко
Отчет «Доступ ИИ-роботов» — это карта того, какие нейросети могут читать ваш сайт. Решите для себя, где вы хотите быть видимыми (поисковые боты ИИ-сервисов), где готовы делиться контентом (обучение моделей) и какие страницы требуют защиты на уровне сервера. Дальше — пара строк в robots.txt и перепроверка в отчете.